پژوهشگران سازوکارهای درونی مدلهای هوش مصنوعی را بررسی میکنند
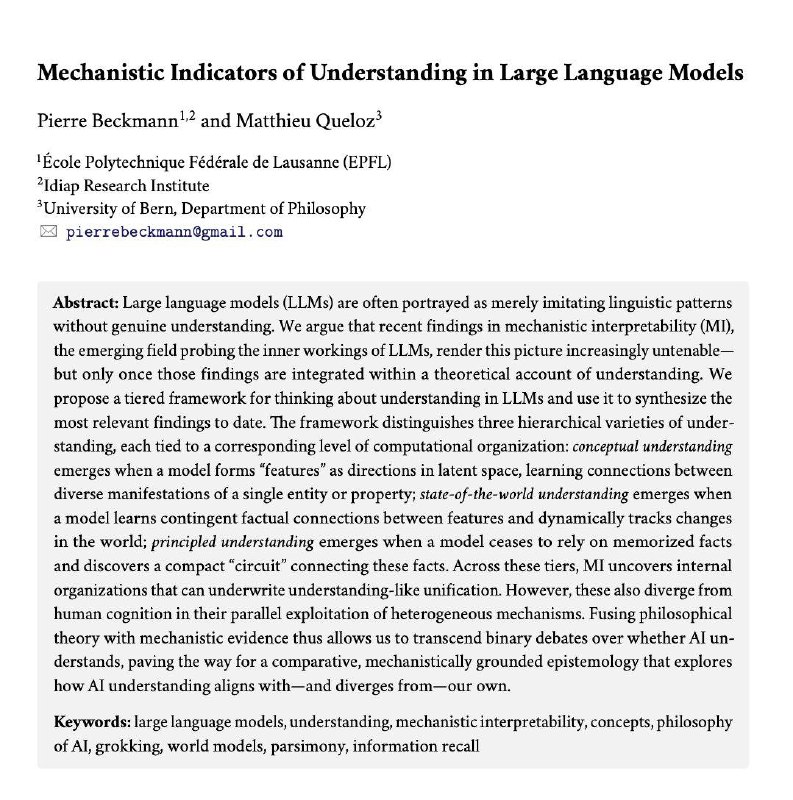
تفسیرپذیری مکانیکی به پژوهشگران امکان میدهد به فرایندهای درونی مدلهای زبانی بزرگ و شکلگیری بازنماییهای مفهومی نگاه نزدیکتری داشته باشند.
پژوهشگران سازوکارهای درونی مدلهای هوش مصنوعی را بررسی میکنند
مطالعات از ویژگیهایی خبر میدهند که مفاهیم و روابط را بازنمایی میکنند. پدیده گروکینگ نیز جهش مدل از حفظ نمونهها به تعمیم قواعد است. این یافتهها به تنهایی درک انسانگونه را ثابت نمیکنند.
تفسیرپذیری مکانیکی به پژوهشگران امکان میدهد به فرایندهای درونی مدلهای زبانی بزرگ و شکلگیری بازنماییهای مفهومی نگاه نزدیکتری داشته باشند.